GPT-6 Astra 到底要多少钱?中小企业想省账单,关键在架构,不在模型
有第三方追踪器把 GPT-6 Astra 的定价报在每百万 token 约 $10(输入)/ $50(输出),上下文窗口约 1M——十足的旗舰级花费。这篇把各家的报价逐一拆开,再用一笔实际的算式说明:真正决定账单厚薄的,是你的架构,而不是模型本身。
前面我们已经把 OpenAI 新旗舰 GPT-6 Astra 能做的事研究过一轮——电脑操作有多强、网络安全能到哪、还有一整套「最 aligned」的说法。但真正决定你用不用它的,往往是另一件事:它到底多少钱,一家中小企业要大量用,到底付不付得起。
先把结论摆出来:上线初期,Astra 肯定是最贵的那一批旗舰之一。你把全部工作都压到它身上,token 账单就会变成报表里最不舒服的那一栏。但成本的大头从来不在模型——而在你把工作怎么分到各个模型上。 同样一个由 Astra 驱动的功能,账单可以厚五倍,也可以薄到一半,差的全是周围那套架构。
这篇会把各家的真实报价逐一拆开,把 Astra 跟它的前代、跟全部其他旗舰模型放在一起比,再诚实地替一家中小企业算一笔数,最后讲清楚有哪几样架构手法,能让旗舰模型也用得起。
先说清楚:Astra 的价钱,最后会是多少
模型定价变得快,下面不每一个数字都是官方的,所以先把「实锤」和「传闻」分开。
- 定价——追踪器把 Astra 报在每百万 token 约 $10 in / $50 out。这是上线期间第三方追踪到的数字,不是 OpenAI 正式开放 API 之后的牌价。
- 上下文——同样有报道指它有约 1M token 的上下文窗口。很大,所以一次请求塞进大量上下文也做得来(下文会看到,这既是卖点,也是成本陷阱)。
- 从哪里拿到——已经上了 OpenRouter,一把 key 就能和其他模型一起用;这一点牵涉成本和 lock-in(后面再讲)。
- 怎么放开——按 CNBC,OpenAI 是分批放:先给一组受限的、受信的机构(包括它申请制的 Daybreak 安全计划,已获批的防御者在那里面),然后才轮到 ChatGPT 各层级(Plus、Pro、Business、Enterprise),API 和云接入跟在后面。攻击性最强的安全能力,是卡在那道受信入口后面的。Forbes 则追问:这些早期的放开,多少是实锤、多少只是宣布?
逐家看:你在哪里可以用到 Astra
模型有一个牌价,但你实际掏多少钱,取决于你走哪条路。
OpenAI API(直接接)。 最正规的来源。上线期报道约每 M token $10 / $50——现行价以 OpenAI 平台定价页 为准。代价是集中:你被绑死在一家 模型提供者 的定价、一份可用性时间表、一套数据处理政策上。一旦有另一款模型对你的 workload 便宜了三成,这个 lock-in 风险就会咬你一口。
OpenRouter(聚合器)。 Astra 已经列在这里。它挡在一堆模型前面,一把 key 通用,你换模型、换 模型提供者 都不用改 code,定价跟住牌价、只多一点点价差。对一个小团队来说,这个「选择空间」很值钱——是在你摸清哪款模型真值回票之前,成本最低的活法,让你在这段摸索期不锁死一家。
AWS。 Astra 也会在放开过程中落到 AWS3。对已经在 AWS 上跑的团队,这代表模型可以直接留在现有的 VPC、计费和访问控制里,不必另接一套。老规矩不变:一般可用之后,记得上 模型提供者 页面核对当时的每-token 价。
Astra 在成本曲线上的位置
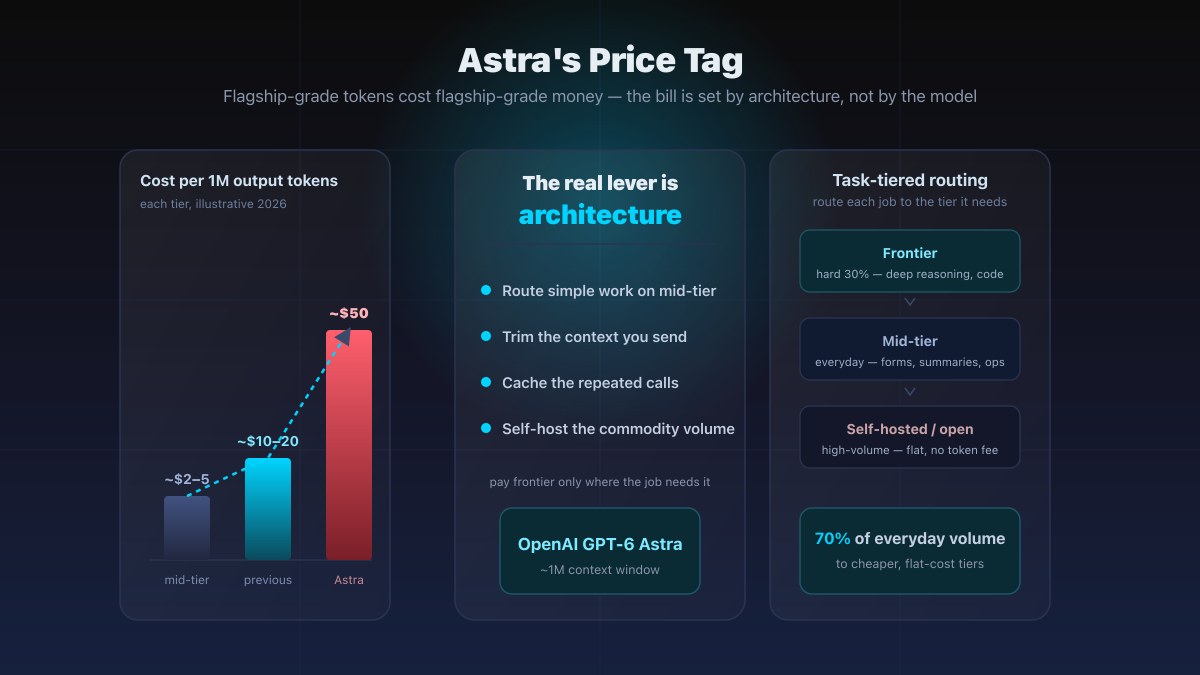
给模型计价,每百万 token 输出才是多数 workload 真正在乎的数,因为生成才花钱。这里是各家旗舰大致的形状(上线时;示意级别,Astra 的 ~$50 是报道数字):
把这张图当成一记警告来看:Astra 比前一代旗舰高一个台阶,比中阶高一个数量级。 这个差价,只有把「什么工作才值得动用 Astra」分得够严,才付得起。
Astra 跟它的前代比
从 GPT-5.6 “Sol” 跨到 Astra,能力的跳跃是真的——准确率更高,电脑操作任务快了大约 47%(上线篇讲过)。但价钱也朝同一个方向走。你买的不是一颗略好一点的模型,你买的是旗舰,按旗舰的价。
两个实际后果:
- 「这件事值不值得上 Astra」的门槛,比用 Sol 时高。 你以前眼睛都不眨就丢给前代旗舰去跑的任务,放到 Astra 的价钱下,未必过得了它自己的成本线。默认答案从「用旗舰」翻成「只用旗舰处理那 30% 真正需要的部分」。
- 1M 上下文,你一个懒字就能把它变成成本倍增器。 一个大窗口会诱你去塞下整个 codebase、所有文件、三年的对话记录,全塞进一次请求。每一粒 token 都计费。大上下文是功能,直到你停止修剪——之后它就是一条账单项目。
Astra 对比全部其他旗舰模型
这里是 Astra 与其他旗舰的对比,比的是驱动中小企业账单的那些维度,不是排行榜。定价级别是有代表性的,要到官方页确认。
| 模型 | 以什么著称 | 定价级别 | 自托管 · Lock-in |
|---|---|---|---|
| OpenAI — GPT-6 Astra | 电脑操作、浏览、写 code、安全(~1M 上下文) | 市内顶尖(~$10 / $50) | 无 · 高 |
| Anthropic — Claude(Opus 4.5) | 长上下文写 code、工具使用 | 旗舰级 | 无 · 高 |
| Google — Gemini(3.x) | 多模态、超长上下文、Workspace | 输入端较低 | 部分 · 中 |
| 开放权重(DeepSeek 等) | 接近旗舰、价格低 | 无 token 费 | 有 · 无 |
两点最值得注意:第一,各家旗舰的 API 没有一家是便宜的——对中小企业,真正的差别在获取途径、在你 workload 上的速度、价钱,不在谁更聪明。第二,要彻底走出每-token 计费,唯一的出路是自托管一颗开放权重模型——这是一条真实、越来越实在的路(我们的 AI 及大语言模型集成服务 就涵盖自托管方案)。
「哪款最好」的诚实版,是每个工程师绕一圈最后都会到的那句:挑最擅长你的任务、你付得起、这个季度就接得上的那款,然后拿你自己的 workload 跑基准。 排行榜告诉你第一梯队在哪;你自己的数字,才告诉你你该在哪里花钱。
中小企业的困局:旗舰的价钱、中小企业的量
这里才是真正要看的地方。用假设的量来算,让你看到机制(你的真实数字会不同,重点是形状):
假设一个功能——一个 AI 支持/运营助手——每月跑 1 亿 token,输入 50M / 输出 50M。
- 全放 Astra(~$10 in / $50 out):
50M × $10 + 50M × $50 = $500 + $2,500 ≈ $3,000 / 月
接着上两个真正管用的手法——把商品化的工作分流到更便宜的级别,把重复的 cache 掉:
- 任务分层路由(70% 的量分到 ~$2 / $10 的中阶;30% 真正需要 Astra):
商品化 35M:$70 + $350 = $420·Astra 15M:$150 + $750 = $900·≈ $1,320 / 月
再加第三个手法——把那 70% 的商品化层级自托管(没有 token 费、固定基础设施):
- 分层 + 自托管商品化层级(自托管 ~$300 固定;Astra 30M 不变):
≈ $1,200 / 月——而且随量增长大致持平
Source: 示意,用上线报道的 Astra 定价(~$10/$50)和有代表性的中阶定价,2026
同一个功能,账单大约缩了两到三倍,而且没有一块是来自更便宜的模型——全来自架构。自托管那一档还有一个其他两档没有的属性:它的成本不再随用量往上走——对一家预测不到下个季度流量的中小企业,这是最关键的一件事。
让旗舰也用得起的几样架构手法
这些都不难。就是几招,按回报从大到小排。
1. 任务分层路由。 每个请求先分类,送到真正需要它的那个级别。填表、抽取、分类、摘要、「这是问题还是工单?」全是商品化工作——中阶模型就做得来,只用一小部分钱。Astra 该留在那最硬的 30%:复杂推理、稍微复杂的 code、多步 agent、任何要碰真实系统的事。
2. 修剪上下文、把重复的 cache 掉。 1M 窗口就是在勾你去过度塞满。把 prompt 剪到任务真正需要的程度,对每次请求都送出去的静态 40%+ 上下文(系统 prompt、产品文档、模板)加prompt 缓存。缓存能把输入端大幅削下来,而输入端,正是大上下文悄悄变账单的地方。
3. 自托管商品化层级。 对高量、低风险的那 70%,自己基础设施上的一颗开放权重模型能彻底拿掉每-token 计费。你拿一张 token 账单,换一个固定、可预测的基础设施成本——而且你的数据不会流出你的网络、流到第三方的计费器。这里,「self-hosted LLM」才从一个 buzzword 变成一条会拉平的账单项目。
4. 保持 vendor 中立。 用聚合器或一层薄薄的封装挡住所有东西,让「模型 X 对这个工作便宜了三成」变成一个 config 变更,而不是一次重写。Lock-in 是一个隐性成本——它悄悄地在每一次往后的价格谈判里向你收税。
5. 让账单看得见。 接上按功能的 token 计量和预算告警。被咬到的团队,都是在发票上才发现激增、而不是在仪表盘上的。你看不见 token 流去哪,就分不了它的层。
6. 从成本审计开始。 买之前,先把现行 prompt 实际有多贵,算一遍,再看有多少比例的请求真正需要旗舰。一个下午的量度,就能告诉你真正的分层比例——而它通常就是「$3,000 的习惯」和「$1,200 那一档」之间的区别。
对一家中小企业,这代表什么
Astra 是真实的能力跳跃,也确实有一小部分任务值那个溢价。但中小企业的默认,不应该是「把一切都放到新的旗舰上」。应该是:
- 先跑基准。 拿你真实的任务,用现用模型和 Astra 各跑一遍,让你自己的数字决定比例。别猜。
- 分流,别一刀切。 从第一天就为多个级别设计,而不是一个模型。
- 盯住放开节奏。 如果你现在就要,付费 ChatGPT 层级是最快的门;API(多数生产自动化其实住在那里)会在分阶段放开后跟上。
- 商品化那部分,先算自托管的价,别预设每-token 账单是躲不掉的。
旗舰之间跑得快,但它们之间的差距不是「够不够聪明」。真正对你重要的,是获取途径、你的 workload 上的速度、价钱,以及模型跟你已有的东西契合多少。所以「选第一名」是错的决定,「选最擅长我的任务、我付得起、这个季度就接得上的那个」才是对的。
结语
Astra 是迄今最强的一代,但价也照顶格收。对一家用量不小的中小企业,结果很直白:账单厚不厚,几乎从来不在模型,全在架构。
把商品化的工作分流下去、把重复的上下文 cache 掉、把高量低风险那一层自托管、保持 vendor 中立、让开支看得见。做到这些,同样一个由旗舰驱动的功能,账单就只剩不做任何优化时的一小部分——而最关键的是:它会随你成长拉平,不是每来一个新用户就往上翻一倍。
如果你已经在跑自动化或 agent,下一步最有用的事,就是给现有的那套堆栈做一次基准测试——它做到什么、做不到什么,摸清楚了,你才知道 Astra 对你是真正划算,还是只是看起来厉害。
外部参考
- CNBC — OpenAI launches GPT-6 “Astra” — 上线报道,Daybreak 放开和分阶段接入模型(2026 年 9 月 3 日)。
- Forbes — OpenAI announces GPT-6 Astra, or does it? — 对放开和早期报道质疑的独立角度(2026 年 9 月 3 日)。
- OpenRouter — GPT-6 Astra — 实时聚合器列表,含现行每-token 定价。
- OpenAI — GPT-6 Astra: A new generation of intelligence — 撑住能力数字的一手发布文。
- OpenAI — Platform pricing — 待 API 一般可用后,确认官方的每-token 价。
相关文章
AMD Threadripper Halo:数据必须留在本地,前沿 AI 也能本地跑
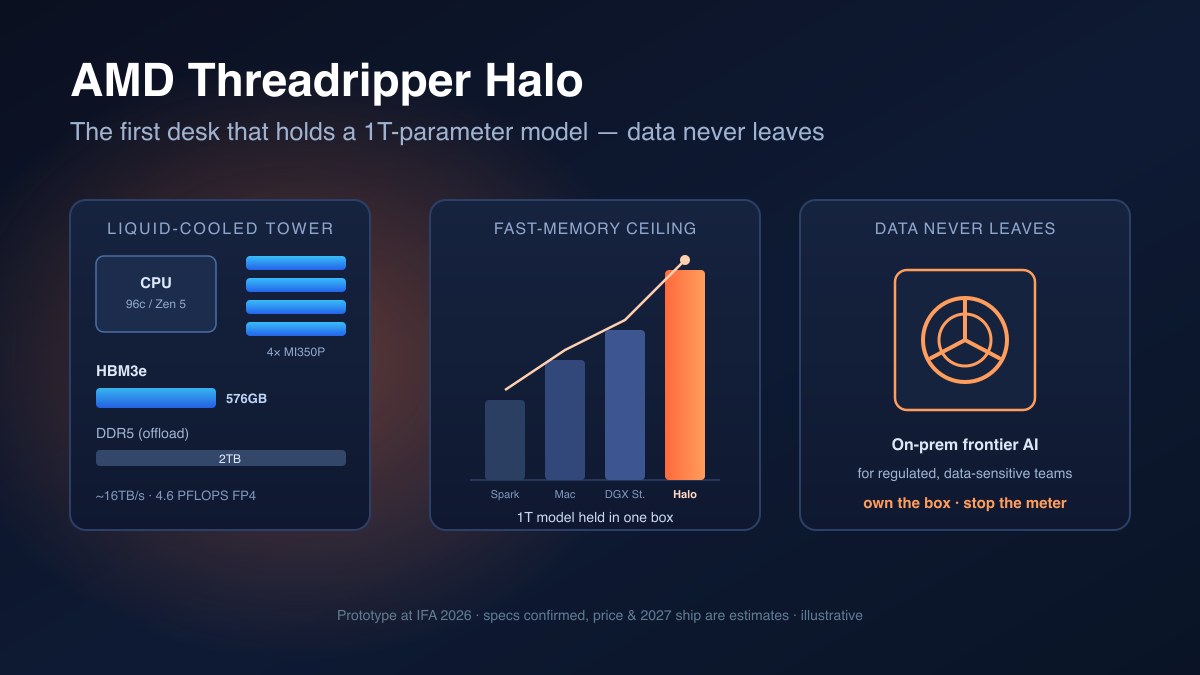
AMD 的 Threadripper Halo 把 96 核 CPU 配上最多 576GB 的 HBM3e——第一台能在桌面机箱里装下一万亿级参数模型、不需要数据中心的机器。这篇说明这块内存真正买到了什么、要花多少钱、又该由谁认真考虑。
阅读文章 →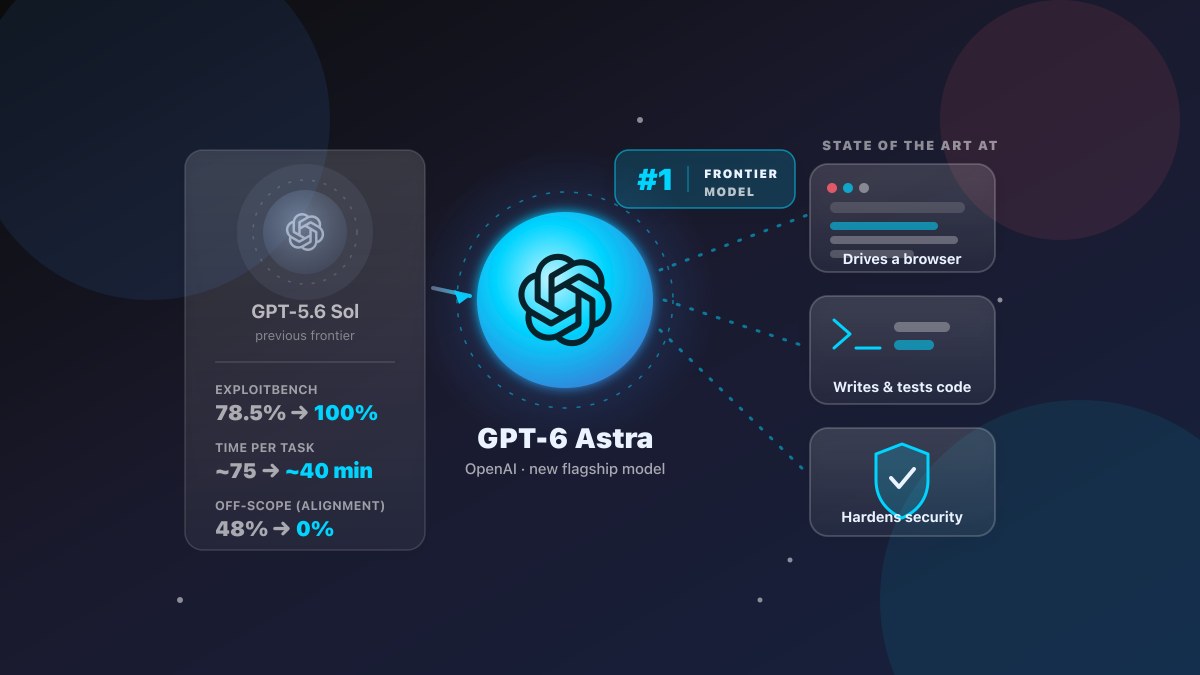
GPT-6 Astra 把 AI 的天花板拉高了一大截——对你的生意有什么影响
OpenAI 旗舰模型 GPT-6 Astra 发布:ARC-AGI-3 拿到 99.9%、FrontierMath Tier 4 拿到 98%、ExploitBench 满分 100%,操作电脑的速度比上一代快约 47%。对中小企业来说,这些数字真正意味着什么、要注意哪些取舍、你什么时候能用上——这篇文章一次讲清楚。
阅读文章 →
2026 年的 Passkey:你的客户已经在用——你的网站让他们进来了吗?
FIDO 2026 年报告:全球已有 50 亿个 passkey 在使用中。90% 的消费者认识它,47% 的人更可能因为记不起密码而放弃购买。这篇讲清楚 passkey 是什么、加入要多少工夫,以及什么时候值得为你的生意做。
阅读文章 →