AMD Threadripper Halo:数据必须留在本地,前沿 AI 也能本地跑
AMD 的 Threadripper Halo 把 96 核 CPU 配上最多 576GB 的 HBM3e——第一台能在桌面机箱里装下一万亿级参数模型、不需要数据中心的机器。这篇说明这块内存真正买到了什么、要花多少钱、又该由谁认真考虑。
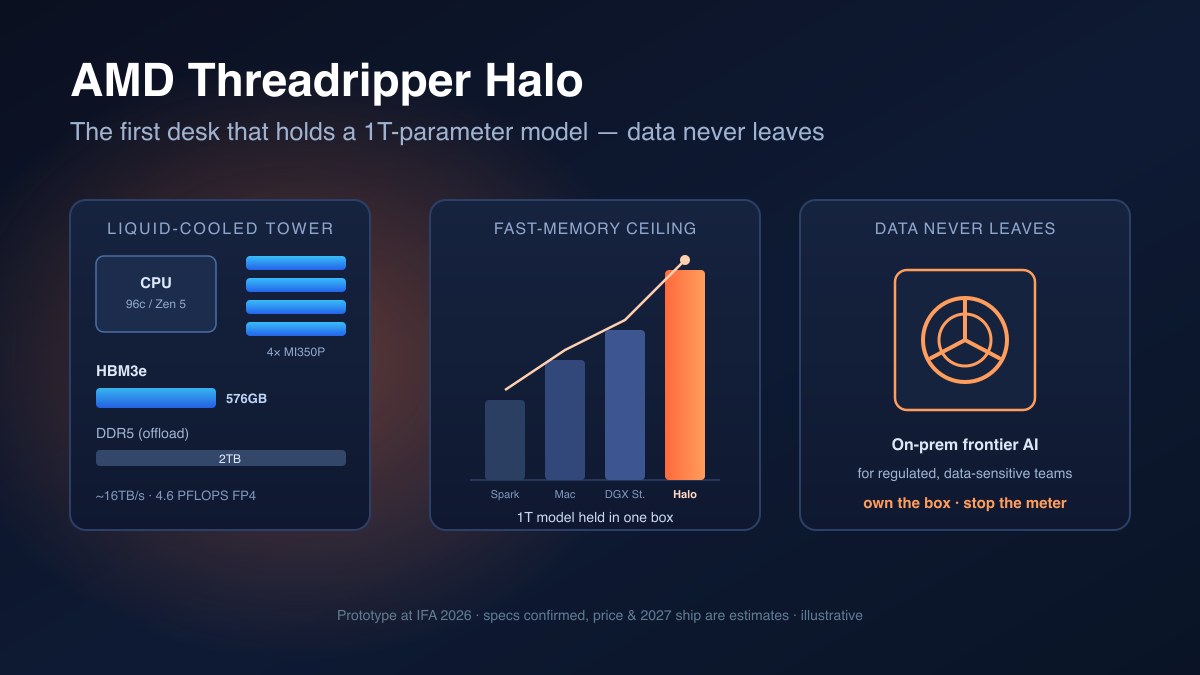
大多数「本地 AI」机器都卡在同一道墙上:模型太大,装不进快内存。机器算得动,只是放不下权重,只能把它们甩到慢速内存、然后卡住。AMD 全新的 Threadripper Halo Station,就是正面撞穿这道墙的尝试。它在柏林 IFA 2026 亮相,是一台液冷桌面工作站,把一颗 96 核 Threadripper CPU 配上最多四张数据中心的 Instinct 加速器——合计 576GB 的 HBM3e 高带宽内存。这足够让一个参数超过一万亿的模型,完整驻留在一台机器里:不用云、不用集群、不用跨网络。
这不是消费级产品,短期内也不会是。AMD 称它为原型——没有定价、没有出货日,分析师估算一台完整机器的价格落在六位数、实际时间窗大概在 2027。但它比规格表看起来更重要,因为它改变了谁能真正跑前沿级模型——那些数据因法律、合约或竞争(例如商业机密)关系不能离开自己管控范围、以往因此用不了云端旗舰模型的机构,如今也能在本地真正跑前沿级模型了。
这篇会先把「确凿事实」和「估算」分开,说明哪些真实的开放权重模型真正装得进这块内存,把这台机器跟其它选项(以及租同样的算力)做比较,并诚实讲出营销不会放在最前面的那一点:这是容量宣言,不是速度宣言。
哪些是确凿事实,哪些还在猜
模型和硬件定价变动快,所以在讲任何数字之前,先把手上的确切事实和第三方的算式分清楚。
- CPU——Threadripper PRO 9995WX,96 核 / 192 线程,Zen 5 架构,128 条 PCIe 5.0 通道。这个通道数量,正是四张全带宽加速器能挂在同一个插槽上、又互不抢带宽的原因。
- 加速器——Instinct MI350P 卡,每张 144GB HBM3e、4TB/s。基础配置有两张;ServeTheHome 确认有扩展到四张的硬件路径,也就是拿到 576GB 的方式。
- 系统内存——加速器内存之外另有最多 2TB 的 DDR5,用来承接那些装不进 HBM 的模型尾部。
- 价格——AMD 没有公布。 你看到的任何金额(包括我们的)都是媒体用零件加总的估算,不是 AMD 的报价。
这台机器,逐项看
CPU 只是配角。真正的主角,是数据中心 GPU 上的那块内存——同一条 AMD 卖进超大规模集群的 Instinct 线,现在包在一台插电就能用的机箱里。
| 部件 | 规格 |
|---|---|
| CPU | Threadripper PRO 9995WX——96 核 / 192 线程、Zen 5、128 条 PCIe 5.0 |
| 加速器 | AMD Instinct MI350P——基础两张、可扩展到四张 |
| 加速器内存 | 每张 144GB HBM3e / 4TB/s → 基础 288GB、最多 576GB |
| 系统内存 | 最多 2TB DDR5(8 通道) |
| 总内存带宽 | 约 16TB/s(4 × 4TB/s) |
| 峰值算力 | 约 4.6 PFLOPS FP4(四卡配置) |
| 散热 | 全液冷(CPU + 加速器) |
| 状态 | 原型——无定价、无出货日 |
「一万亿参数」——是容量宣言,不是速度宣言
这一段,正是发布会刻意含糊的地方——也是你若要据此做规划、最该在意的一点。
「能跑一万亿参数模型」是一句空间计算的说法。大约在 4-bit 精度下,每个参数约占半个字节,所以一个一万亿参数的模型,权重大约 550GB。这装得进 576GB 的 HBM3e——刚好——而 2TB 的 DDR5 就在那里承接多出来的部分。权重装得下。 这是真正站得住的成就。
它没有说的是:能以有用的速度去服务一个一万亿参数模型。那个规模的前沿模型,通常要分散在一个互连的加速器集群上,是有原因的:吞吐量。一台单机塔装着 1T 模型,是一台真正有用的研究与实验机器——你跑得动它、看得到它、能微调它、能在上面做本地 inference。但它今天不是服务集群的即插即用替代品。预期它能拿来用、而不是能扛生产流量。
哪些真实的开放权重模型真正装得进
理解 576GB HBM3e 加 2TB DDR5 最有用的方式,是分成两层:装在 HBM 里的(快)跟需要用 DDR5 承接的(能用、但较慢)。下表列出各模型的权重占用,采用一个代表性的量化精度。
| 开放权重模型 | 参数(实际激活) | 约占用 | 跑在哪 |
|---|---|---|---|
| Llama 4 Maverick(MoE) | 400B(激活 17B) | ~420GB(Q8) | 在 HBM——快 |
| GLM-4.5(MoE) | 355B(激活 32B) | ~373GB(Q8) | 在 HBM——快 |
| DeepSeek V4-Flash(MoE) | 284B(激活 13B) | ~298GB(Q8) | 在 HBM——快 |
| Qwen3-235B(MoE) | 235B(激活 22B) | ~247GB(Q8) | 在 HBM——快 |
| DeepSeek V3(MoE) | 671B(激活 37B) | ~369GB(Q4) | 在 HBM(Q4) |
| DeepSeek V4-Pro(MoE) | 1.6T(激活 49B) | ~880GB(Q4) | DDR5 承接——研究级 |
那个「激活」数字,就是 MoE 设计的意义所在:一个 400B 的模型,每个 token 只跑其中 17B 的权重,就能给你接近前沿级品质、又把单 token 成本压得很低——这正是这些模型值得本地留存的原因。另外注意 Qwen3-Max 不是开放权重(只有 API),所以不在这张表——这里的开源旗舰是 DeepSeek、Llama 4、GLM,以及 Qwen3 的开放 235B。
它的位置,对上其它选项
Halo 不比价格、也不比好不好买。它比的是上限——没有别家公开在推一台能装下一万亿参数模型、又不用跨网络拆分的桌面机器。各机型,按真正影响决策的维度:
| 机器 | 快内存 | 软件栈 | 约价 |
|---|---|---|---|
| Threadripper Halo | 最多 576GB HBM3e(+2TB DDR5) | ROCm | ~$100–150K(估) |
| Nvidia DGX Station | 252GB HBM3e(+496GB) | CUDA | ~$100K |
| Nvidia DGX Spark | 128GB 统一 | CUDA | ~$4K |
| Apple Mac Studio(M5 Ultra) | 512GB 统一 | MLX / Metal | 消费级 |
对上最直接的对手 Nvidia DGX Station(72 核 Grace + B300、252GB 的 HBM3e),AMD 的数字站得住:总内存约 3.4 倍、内存带宽超过两倍。但 DGX Station 的优势是 CUDA 栈——cuDNN、TensorRT,以及数量庞大、早就写在 CUDA 上的既有研究代码——多数严肃的 AI 管线还是建在那上面。
DGX Spark(128GB 统一)和 M5 Ultra Mac Studio(最多 512GB)是另外一个类别:让中型模型与开发都用得起的本地 AI,不是一万亿参数研究。Spark 单机最高可跑约 200B 模型的 inference(四台互连最多 ~700B);Mac Studio 是消费价、业余玩家跑开放模型时默认的那台。两台都够不到 Halo 的上限。
但真正的替代选项,不是另一台机器——而是根本别买,改按小时租算力。
买下来,还是租:实实在在的计算
一台六位数的机器,只有在跟「租同样能力的成本」比过之后才讲得通。第三方的云端实时牌价(RunPod,2026 年中)单颗顶级 GPU 的时租大约是:
- H100——约 $3.49/小时
- H200——约 $4.59/小时
- B200——约 $6.79/小时
- B300——约 $7.89/小时
连续 24/7 跑下来,回本问题就变成:一台约 $150K 的机器,能买到多少年「租单颗 GPU」的时间?
照我们看成本曲线的思路来读:一台六位数的机器,相当于买下两年顶级 GPU 的算力,或差不多五年的常见 H100——过了这个点,就不再多付一毛、数据也不离开自己的网络。所以,如果你跑的是持续、常开的 inference、数据又敏感,这笔账怎么算都该买下来;如果你做的是零散、尖峰、实验性的工作,租更划算——你只为真正用到的那些小时付费。
实在的一句话:一台 $150K 的机器,约等于两年的顶级云端 GPU,然后账单就停了。 对一支跑常开 on-prem inference、数据又敏感的团队,这就是全部论点。对其他人,还是按小时计费比较划算。
ROCm 问题(以及为什么 inference 是它赢回来的地方)
对任何 AMD 加速器,绕不过去的那座大山就是 ROCm——AMD 对 CUDA 的答案。长久以来这个差距是真实的,也是多数研究员不管规格都默认选 Nvidia 的原因。
有两点转变,而且对一个本地 inference 的买家特别重要。第一,ROCm 10.0(2026 年发布)把 vLLM 和 SGLang 的支持做到了可直接落地——这两个 runtime 正是本地服务大模型要用的,且附验证过的容器和 wheel。第二,也是关键:inference 是 ROCm 跟 CUDA 最接近持平的地方。还剩下的差距,在自订训练kernel,以及整个配套生态的广度。一台工作站的全部工作就是跑一个开放权重模型,这恰恰是差距最小的那种 workload。
谁才真正该买(谁不该买)
实在一点看潜在买家,因为真正的买家群比标题听起来窄。
如果你符合以下情况,它就是为你准备的:
- 你的数据不能离开本地——受规范的产业(医疗、金融、国防相关)、客户机密的 workload、你不会送到第三方 API 的 IP。
- 你需要完整权重访问——检视、可解释性、自订 kernel——托管的 API 在结构上就是错的工具。
- 你跑持续、常开的 inference,而且多年租金已经累积到值得自购的程度。
- 你需要模型常驻、可用、完全不需要云账号。
如果你符合以下情况,它大概不适合你:
- 你是独立开发者、或做零散工作的小团队——DGX Spark 或一台高内存的 Mac Studio 便宜得多,也够跑中型模型。
- 你的 workload 是标准训练/微调、在云端就能跑——ROCm 生态在那里还是弱点。
- 你想这个季度就到手——这是 2027 的机器,两卡跟四卡配置甚至还没确定是不是正式 SKU。
现实上的早期买家,是有专属硬件预算、又有数据治理要求的实验室与企业——不是广大的 AI 市场。AMD 做的是一台字面意义上的 halo 产品:定位在旗舰/前沿、要表明本地前沿是真的,不是要冲走量的机器。
对一家数据敏感的企业,这代表什么
如果你就是那种用 AI、但数据不能送到第三方 endpoint 的企业,这台机器是第一台有公信力的单机答案——就算你现在不买,它也值得留意。
- 本地的上限正在快速上升。 本地 AI 的瓶颈一直是内存容量、不是算力——而这台机器让那道上限,比桌面上任何别的东西高了一个数量级。一个 2025 年要靠云 endpoint 的 workload,2027 年可能在一台便宜得多的机器上变成本地 workload。
- 现在就规划自托管的路,之后再买。 你不需要 Halo 就能开始想你的数据该住哪。那套架构——哪些模型、哪些留本地、哪些能走 API、怎么保持 vendor 中立——不管机器是 $4K 还是 $150K,都是同一套。
- 层级要配对敏感度。 不是每个模型都需要 $150K。一台 $4K 机器上的一个中型开放模型,就能处理很多事;那台一万亿参数的机器,是给真正不能动的数据用的。
结语
Threadripper Halo 是第一台能真正撑起前沿级本地 inference 的桌面机器——一台机器里装下一万亿参数模型、数据永不出门。它是原型、按任何方式估算都很贵、2027 才出货。
但它指向的能力,正是对数据敏感的工作最要紧的那一个:一台你拥有的模型,跑在一台你拥有的机器上,账单会停、而不是按 token 累计。 对那些以此为约束的企业,决定不是「买 Halo」——而是「开始为你移不动的数据,设计 on-prem 的路径」。这是这个季度就能做的决定,远早于机器到手。
如果你在用 AI、而你的数据有治理上的理由要留在这里,下一步最有用的,是一个直白的问题:你哪些 workload 可以放本地、把这件事落地要花多少钱? 我们跟你一起设计那条路——模型分层、自托管、vendor 中立——让这台机器到手时,你已经准备好了。
外部参考
- The Register — AMD’s Threadripper Halo is a local-AI workstation for researchers with deep pockets — 发布报道、标题规格、576GB / 16TB/s 说法(2026 年 9 月 4 日)。
- ServeTheHome — AMD Announces Threadripper Halo Station — 规格拆解、两到四张 MI350P 的路径、跟 DGX Station 比较。
- TechPowerUp — AMD Introduces Threadripper Halo Station at IFA 2026 — IFA keynote 报道。
- Nvidia — DGX Spark — 官方 128GB / 200B-inference 规格。
- Apple — Mac Studio specs — M5 Ultra 512GB 统一内存。
- RunPod — pricing — 实时每小时云端 GPU 牌价,用于拥有 vs 租借的算式。
- AMD — ROCm 10.0 release — vLLM / SGLang 的可直接落地支持。
相关文章
GPT-6 Astra 到底要多少钱?中小企业想省账单,关键在架构,不在模型
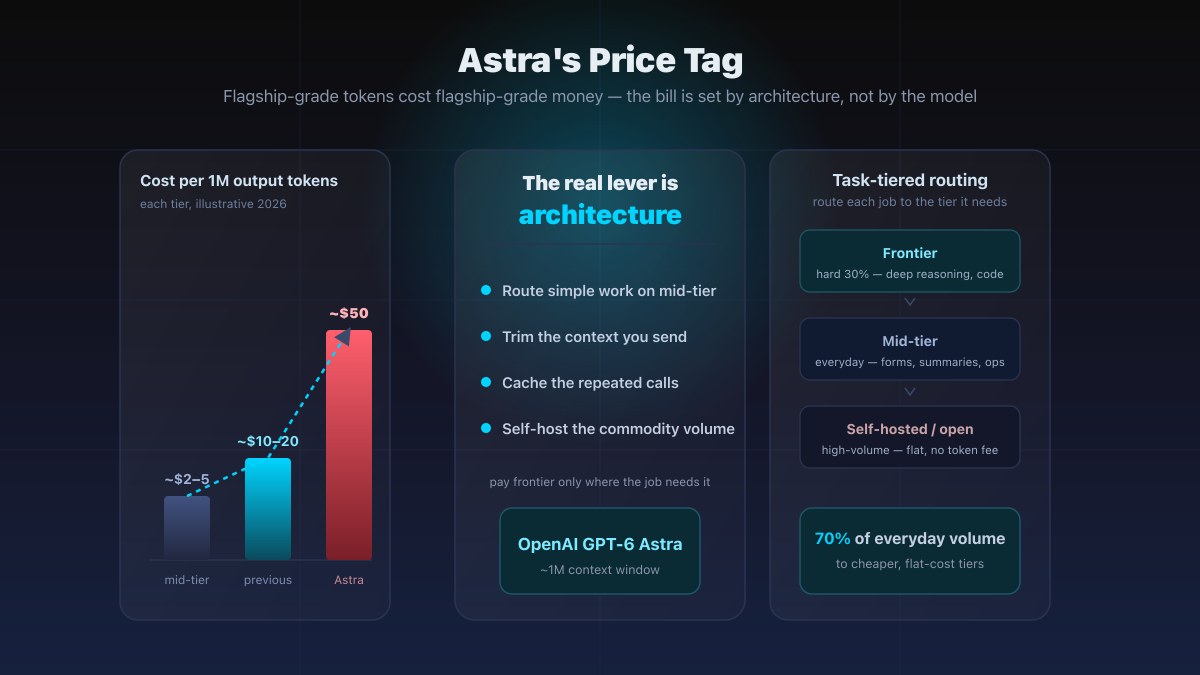
有第三方追踪器把 GPT-6 Astra 的定价报在每百万 token 约 $10(输入)/ $50(输出),上下文窗口约 1M——十足的旗舰级花费。这篇把各家的报价逐一拆开,再用一笔实际的算式说明:真正决定账单厚薄的,是你的架构,而不是模型本身。
阅读文章 →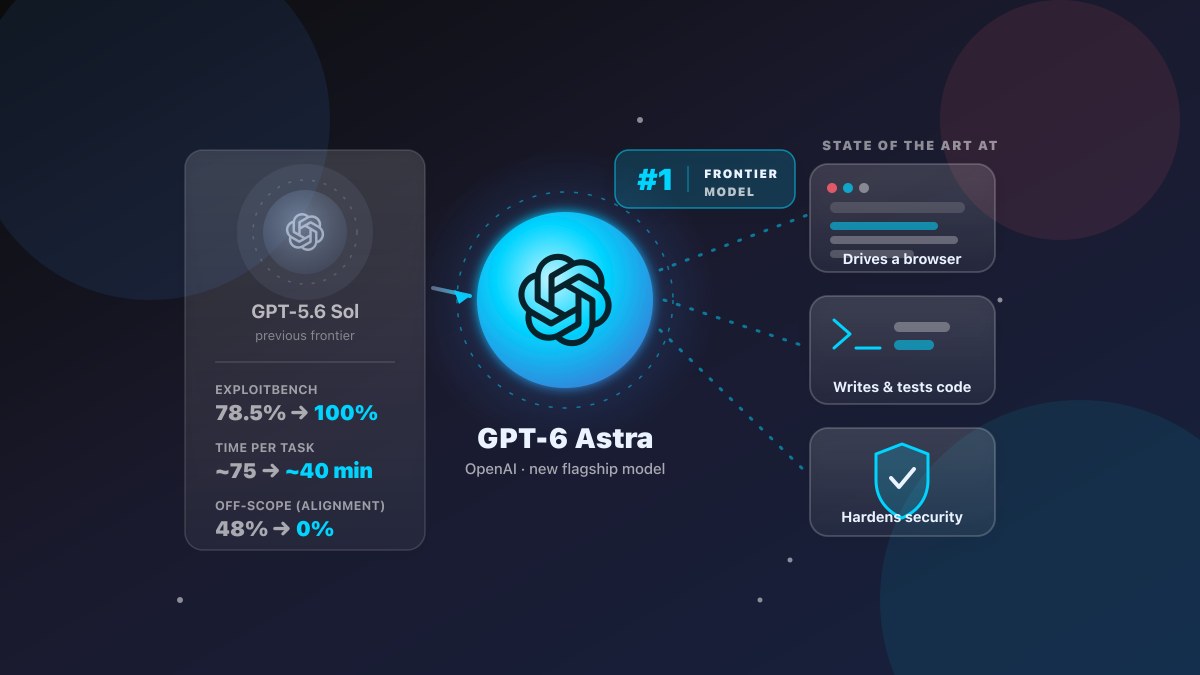
GPT-6 Astra 把 AI 的天花板拉高了一大截——对你的生意有什么影响
OpenAI 旗舰模型 GPT-6 Astra 发布:ARC-AGI-3 拿到 99.9%、FrontierMath Tier 4 拿到 98%、ExploitBench 满分 100%,操作电脑的速度比上一代快约 47%。对中小企业来说,这些数字真正意味着什么、要注意哪些取舍、你什么时候能用上——这篇文章一次讲清楚。
阅读文章 →
2026 年的 Passkey:你的客户已经在用——你的网站让他们进来了吗?
FIDO 2026 年报告:全球已有 50 亿个 passkey 在使用中。90% 的消费者认识它,47% 的人更可能因为记不起密码而放弃购买。这篇讲清楚 passkey 是什么、加入要多少工夫,以及什么时候值得为你的生意做。
阅读文章 →