GPT-6 Astra 把 AI 的天花板拉高了一大截——對你的生意有甚麼影響
OpenAI 旗艦模型 GPT-6 Astra 出爐:ARC-AGI-3 拿到 99.9%、FrontierMath Tier 4 拿到 98%、ExploitBench 滿分 100%,操作電腦的速度比前代快約 47%。對小生意而言,這些數字真正代表甚麼、要注意哪些取捨、你什麼時候能用上——這篇文章一次講清楚。
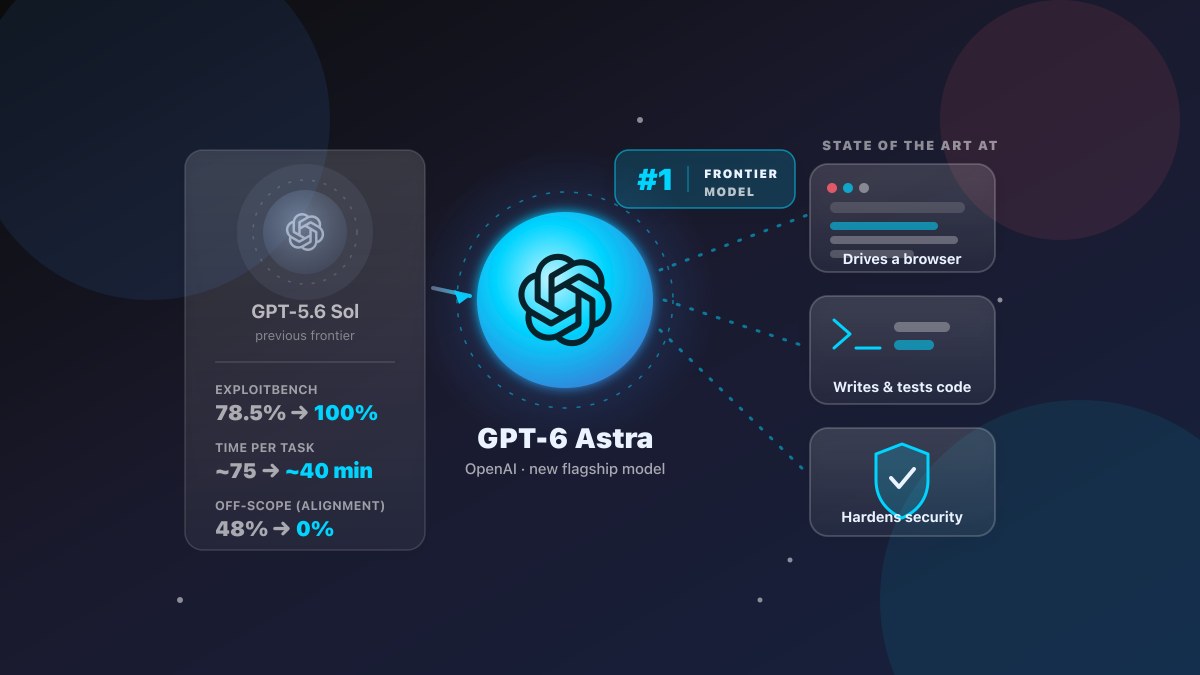
OpenAI 悄悄上線沒幾天,GPT-6 Astra 已經成為整個業界都在談的模型。OpenAI 稱它是「我們歷來最聰明、而且——這點很關鍵——最 aligned 的模型」。它放出的話很有分量:操作電腦、寫程式、資安,三項都宣稱做到最先進水平。
這不是又一個更快的聊天機器人。如果數字站得住,小生意能交給 AI agent 的任務範圍會有一次真正的跳躍,而且不用人在旁邊盯著。這篇文章就把真正的進步和行銷話術拆開,講清楚它對你的網站和營運到底有甚麼用。
GPT-6 Astra 到底是甚麼
簡單說,Astra 是 OpenAI 的新旗艦模型,就坐在你大概已經聽過的 GPT-5.6「Sol」上面。OpenAI 稱它在這六件事上都是最先進水平:computer use、瀏覽網頁、軟體工程、資安、科學,以及專業工作。
其中「computer use」和「aligned」兩個詞,值得停下來想一想。
- Computer use:模型真的能在電腦上動手——點一個真實的網頁瀏覽器、填表單、更新 CRM 裡的紀錄、開 app、順手確認頁面上的功能有沒有用。不是講給你聽怎麼做——是直接做。
- Aligned:它更聽指令,待在你要求的範圍內,不隨便跑去做沒交代的事。OpenAI 自己的文章把它擺在頭號功能的位置——當你讓 agent 去碰真實系統,這正是最要緊的一環。
主打數字——白話版
先講大數字,再逐個翻譯成人話。
Source: OpenAI, GPT-6 Astra 發布, 2026 年 9 月 1 日
在 OSWorld 2.0——一個專門考「真的在電腦上做事」的基準測試——Astra 準確度更高,而且跑得更快:
準確度更高,而且每項任務的時間又縮了近一半。對一條你本來就在自動化的流程,這就是「隔夜才跑得完」和「白班就能跑起來」的分別。
真正有爭議的部分
只講好消息就不誠實了。有兩個保留,都跟你直接相關。
資安能力是把雙面刀。 ExploitBench 考的正是把已知漏洞變成可運作的 exploit——Astra 拿到滿分,前一代旗艦模型是 78.5%。OpenAI 內部測試期間還順手挖出兩個先前未知的 zero-day 漏洞,並已向相關維護者通報。
OpenAI 表示,這已經跨過它 Preparedness Framework 裡的**「Critical」門檻**。所以這次上線是分批放的:先給一組有限的組織(包括它的 Daybreak 資安計畫),之後才輪到 ChatGPT 各層級、API 和 AWS——攻擊性最強的資安任務目前仍受限,官方預設的方向是防禦性用途,例如安全的程式碼審查和打 patch。
「有爭議」的,是你能審計到幾成。 TechCrunch 的報導指出,Astra 使用的一種推理技術,讓它內部的推理鏈比前代模型更難被監控。OpenAI 自己的文章也認了:Astra 書面化的推理比 GPT-5.6 Sol 難監控,提升可監控性已被列為持續推進的重點。
對一門小生意,它真正意味著甚麼
把基準測試那些數字拿掉,實質的賣點就一句話:你能委派給 agent 的天花板變高了——範圍、速度、可靠性三方面都往上走。
OpenAI 自己舉的例子,換成生意語言就是這些:
- 填寫線上表單,更新 CRM 裡的客戶紀錄
- 整理你的行事曆、排程
- 做線上調查,把摘要直接起草進你的 email 或文件編輯器
- 分析數據,產生圖表
- 建立網站並跑前端 QA,確認功能真的能用
- 安裝並測試軟體,順手排查畫面上看到的問題
按 OpenAI 的說法,Astra 也更聽得懂你的模板,產出的文件、試算表和簡報更貼你的風格——這道坎,正是一般 AI 產出「交出來還要重做」和「拿到就能用」之間的分別。
對一個已經在跑 agent 流程的團隊,實際該做的一件事:API 一開,就拿現有的 agent 流程重新跑一次基準測試。 同一條流程,前一代模型要 75 分鐘的,現在 40 分鐘可能就完事;你之前放棄、嫌「太瑣碎不值得自動化」的任務,可能突然變得值得做。
你甚麼時候真正能用上
上線是分批的,時間取決於你走哪條路徑:
- 現在——一組有限的組織,包括 OpenAI 的 Daybreak 資安計畫。
- 未來幾天——ChatGPT Plus、Pro、Business、Enterprise 使用者。
- 稍後——OpenAI API 和 AWS。
換言之:最快的路徑是買一個付費 ChatGPT 座席;API 整合(多數生意的自動化其實住在那裡)大概一週內跟上。
和其他旗艦模型相比,它站得住嗎
先講誠實的前提:上面那些主打數字都是 OpenAI 自己的,發布時公布的。Anthropic、Google 和其他廠商,各報各家的成績——而基準成績只有在同一個 benchmark、同一版本、同一條件之下才真正可比。所以你很少看到一張「Astra 對所有人」的乾淨同質比較表。以下是按各家目前對自家旗艦模型的定位畫得出來、也站得住的圖景(截至 2026 年 9 月):
| 供應商 | 以甚麼著稱 | 目前最強的區塊 |
|---|---|---|
| OpenAI — GPT-6 Astra | Computer use、agentic 瀏覽、寫程式,以及專項的資安推進 | 真的去操作電腦和瀏覽器——據報比自家前代快約 47%,準確度也更高 |
| Anthropic — Claude(Opus 4.5) | 長上下文的 agentic 寫程式和工具使用;擅長待在你交代的任務範圍內 | 長時間的寫程式、大型程式碼庫與長上下文的 agent 工作 |
| Google — Gemini(3.x) | 原生多模態(圖像 + 影片 + 音訊)、超長上下文、與 Google/Workspace 深度整合 | 多模態、長上下文,以及 Google 生態系內的工作流 |
| DeepSeek 及其他開放權重模型 | 以遠低的成本做到旗艦級品質 | 高用量、低風險的工作——單價 token 是決定因素的那些場景 |
這張表能看出兩件事。
Astra 最鮮明的差異化,是電腦和資安兩條線。 在 OSWorld 那種「真的去操作電腦」的任務上,前代到後代的進步,加上 ExploitBench 的成績,讓它站進一條其他旗艦模型目前沒有這樣主打的賽道。如果你腦中的「agent」就是一個瀏覽器、一個表單、一個 CRM,那這就是頭號故事。
但「旗艦」是一場三方比賽,差距不在「夠不夠聰明」。 單看原始推理,三家頂尖實驗室公布的成績都落在同一個頂尖十分位區間;對生意真正要緊的差異,是取得途徑、在你的工作負載上的速度、價格,以及模型跟你已有的生態系有多契合。所以「挑第一名」是錯的決定——「挑最擅長我的任務、付得起、這個季度就能整合的那個」才是對的。
怎麼選(實務版)
- 你的瓶頸是瀏覽器/電腦操作類任務的速度——Astra 最值得留意;不過截至今文撰寫時,API 存取可能仍分批中。想盡早在真實任務上試出手感,付費 ChatGPT 座席是最快的入口。
- 你做長時間的寫程式、或長上下文的 agentic 工作——Claude(Opus 4.5)仍是多數工程團隊的參照基準;先留在你的備選清單裡,等 Astra 的 API 開門再重跑基準測試。
- 你的工作是多模態的,或者住在 Google 生態系裡——Gemini 的長上下文和原生圖像/影片能力很難被比下去,Workspace 整合也是實打實的營運優勢。
- 單價 token 是主要限制、任務又高量低風險——這些供應商的中階模型,或一個開放權重選項,通常就能用一小部分旗艦成本把活幹完。
- 你已經押注在一家供應商上——切換成本(自訂工具、prompt、安全審查)往往比基準測試的差距還高。換平台之前,先拿自己的工作負載跑一輪比較。
還有一個常被忽略的:不是每件事都需要最貴的模型。 旗艦模型收的就是旗艦單價,「最好的模型」不等於「你應該付最貴的那個」。很多真實的生意工作——資料錄入、例行查詢、格式化、簡單生成——高量而低風險,一個中階模型(或更便宜的開放權重選項)就能用一小部分成本搞定。好的模型選型在這裡變成一個財務決策:只在活真的需要的地方付旗艦價格,差額就留在你的生意裡——去投產品、人或者成長——而不是悄悄漏進 API 帳單。AI 落地裡真正見功力的,是按任務挑對工具,不是只追「最聰明」的那一個。
等 Astra 的 API 到了你手上,唯一誠實的比較就是你自己的:拿一組真實任務,分別用現用模型和 Astra 跑一遍,讓你的數字來說話。排行榜告訴你第一梯隊在哪裡;你自己的基準測試才告訴你,它有沒有跑到你前面。
結論
這是一次真實的能力跳躍,不是行銷上的一點小漲幅——發布背後是有具體、可查的數字撐著的,「最 aligned」也是真正新加的焦點。但它帶著一個真實的取捨:能力更強,也更難看進裡面。
對一門生意,機會很具體:更多任務變得更可自動化、更快、而且在你劃定的範圍內更可靠。 風險則是信了一個你沒法完全審計的 agent。合理的路徑跟任何新工具一樣——從窄開始,先放可驗證的活,等它證明自己再擴大。
如果你已經在跑自動化或 agent,下一步最有用的事,就是給現有的那套堆疊做一次基準測試——它做得到甚麼、做不到甚麼,摸清楚了,你才知道 Astra 到底把線幫你移動了多遠。
外部參考
- OpenAI — GPT-6 Astra: A new generation of intelligence — 一手發布文章,基準測試數字都在這裡(2026 年 9 月 1 日)。
- OpenAI — Path to Astra: critical capabilities and frontier safeguards — 能力與安全/保護措施的深入解析。
- OpenAI — Safety overview: GPT-6 Astra — Preparedness 門檻與監控的細節。
- OpenAI — The Defender’s Window — 談前沿資安能力對防禦者而言如何是一把雙面刀。
- TechCrunch — OpenAI launches Astra, its powerful (and controversial) new model — 獨立報導,覆蓋發布、“opaque recurrence”/可監控性爭議和上線細節(2026 年 9 月 3 日)。
相關文章
GPT-6 Astra 到底多貴?中小企業想省帳單,關鍵不在模型,而在架構
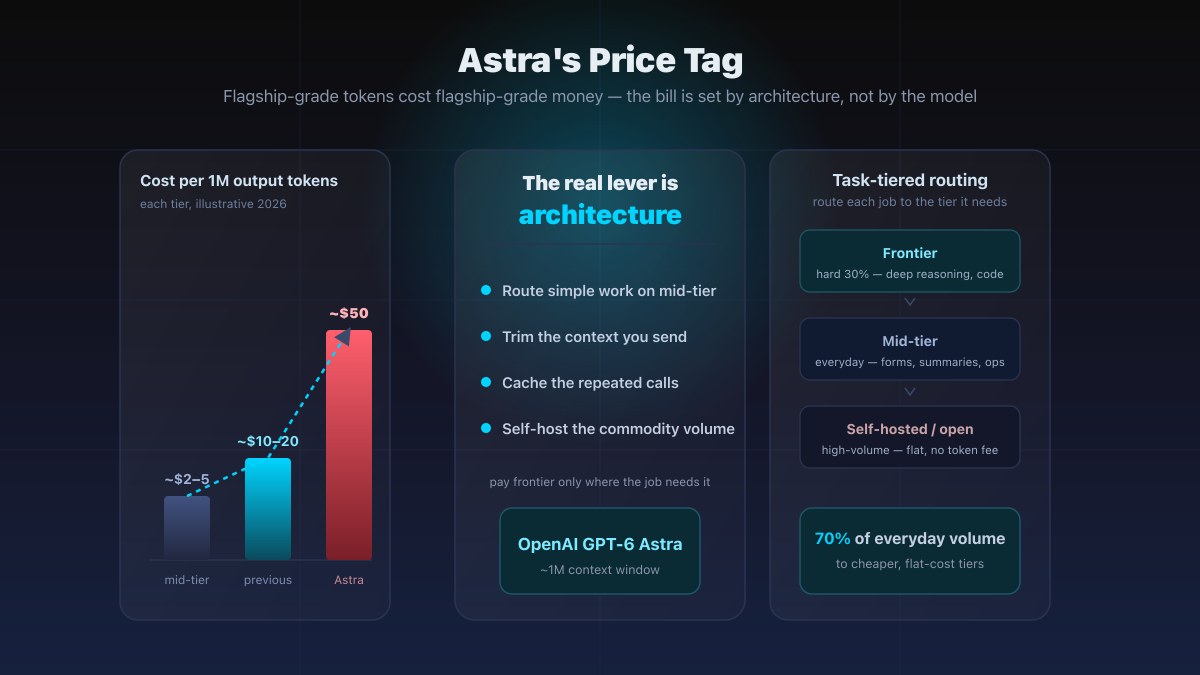
第三方追蹤器把 GPT-6 Astra 的定價報在每百萬 token 約 $10(輸入)/ $50(輸出),上下文窗口約 1M——旗艦級的花費。這篇把各家報價逐一拆開,再用一筆實際的算式說明:真正決定帳單厚薄的,是你的架構,不是模型本身。
閱讀文章 →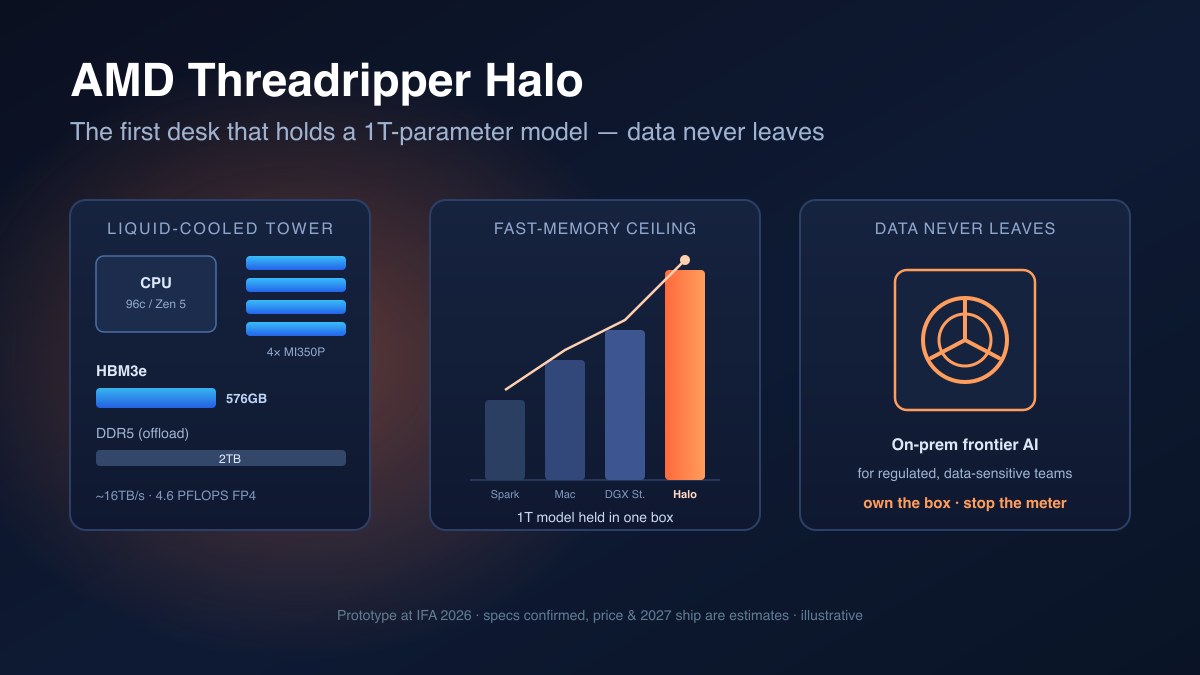
AMD Threadripper Halo:當你的資料必須留在本地,前沿 AI 也能在本地跑
AMD 的 Threadripper Halo 把 96 核 CPU 配上最多 576GB 的 HBM3e——第一台能在桌上級機箱裡裝下一萬億級參數模型、不需要數據中心的機器。這篇說明這塊記憶體真正買到了甚麼、要多少錢、又該由誰認真考慮。
閱讀文章 →
2026 年的 Passkey:你的客戶已經在用——你的網站讓他們進來了嗎?
FIDO 2026 年報告:全球已有 50 億個 passkey 在使用中。90% 的消費者認識它,47% 的人更可能因為記不起密碼而放棄購買。這篇講清楚 passkey 是什麼、加入要多少工夫,以及什麼時候值得為你的生意做。
閱讀文章 →