AMD Threadripper Halo:當你的資料必須留在本地,前沿 AI 也能在本地跑
AMD 的 Threadripper Halo 把 96 核 CPU 配上最多 576GB 的 HBM3e——第一台能在桌上級機箱裡裝下一萬億級參數模型、不需要數據中心的機器。這篇說明這塊記憶體真正買到了甚麼、要多少錢、又該由誰認真考慮。
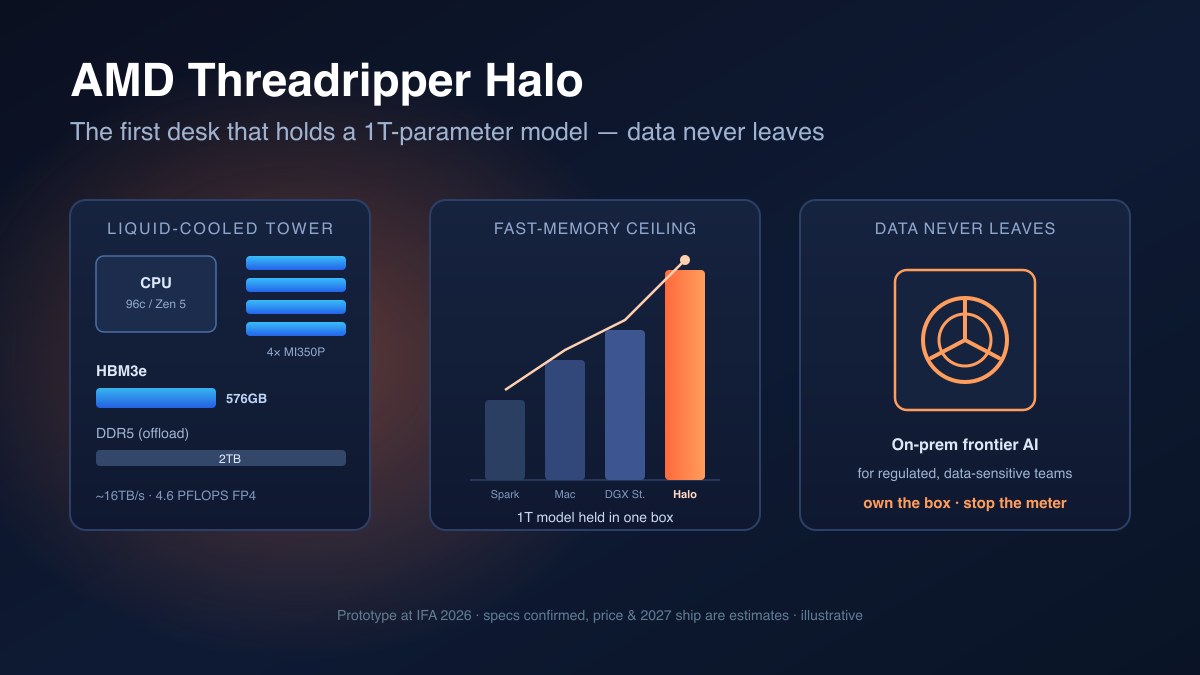
大多數「本地 AI」機器都卡在同一道牆上:模型太大,裝進不了快記憶體。機器算得動,只是放不下權重,只好把它們甩到慢速記憶體、然後卡住。AMD 全新的 Threadripper Halo Station,就是正面撞穿這道牆的嘗試。它在柏林 IFA 2026 亮相,是一台液冷桌上工作站,把一顆 96 核 Threadripper CPU 配上最多四張數據中心的 Instinct 加速器——總計 576GB 的 HBM3e 高頻寬記憶體。這足夠讓一個參數超過一萬億的模型,完整常駐在一台機器裡:不用雲端、不用集群、不用跨網絡。
這不是消費級產品,短期內也不會是。AMD 稱它為原型——沒有定價、沒有出貨日,分析師估算一台完整機器的價格落在六位數、實際時間窗大概在 2027。但它比規格表看起來更重要,因為它改變了誰能真正跑前沿級模型——那些資料因法律、合約或競爭(例如商業機密)關係不能離開自己管控範圍、以往因此用不了雲端旗艦模型的機構,如今也能在本地真正跑前沿級模型了。
這篇會先把「確鑿事實」和「估算」分開,說明哪些真實的開放權重模型真正裝得進這塊記憶體,把這台機器跟其它選項(以及租同樣的算力)做比較,並誠實講出行銷不會放在最前面的那一點:這是容量宣言,不是速度宣言。
哪些是確鑿事實,哪些還是猜
模型和硬體定價變動快,所以在講任何數字之前,先把手上的確鑿事實和第三方的算式分清楚。
- CPU——Threadripper PRO 9995WX,96 核 / 192 執行緒,Zen 5 架構,128 條 PCIe 5.0 通道。這個通道數量,正是四張全頻寬加速器能掛在同一個插槽上、又互不搶頻寬的原因。
- 加速器——Instinct MI350P 卡,每張 144GB HBM3e、4TB/s。基礎配置有兩張;ServeTheHome 確認有擴展到四張的硬體路徑,也就是拿到 576GB 的方式。
- 系統記憶體——加速器記憶體之外另有最多 2TB 的 DDR5,用來承接那些裝不進 HBM 的模型尾部。
- 價格——AMD 沒有公布。 你看到的任何金額(包括我們的)都是媒體用零件加總的估算,不是 AMD 的報價。
這台機器,逐項看
CPU 只是配角。真正的主角,是數據中心 GPU 上的那塊記憶體——同一條 AMD 賣進超大規模集群的 Instinct 線,現在包在一台插電就能用的機箱裡。
| 部件 | 規格 |
|---|---|
| CPU | Threadripper PRO 9995WX——96 核 / 192 執行緒、Zen 5、128 條 PCIe 5.0 |
| 加速器 | AMD Instinct MI350P——基礎兩張、可擴展到四張 |
| 加速器記憶體 | 每張 144GB HBM3e / 4TB/s → 基礎 288GB、最多 576GB |
| 系統記憶體 | 最多 2TB DDR5(8 通道) |
| 總記憶體頻寬 | 約 16TB/s(4 × 4TB/s) |
| 峰值算力 | 約 4.6 PFLOPS FP4(四卡配置) |
| 散熱 | 全液冷(CPU + 加速器) |
| 狀態 | 原型——無定價、無出貨日 |
「一萬億參數」——是容量宣言,不是速度宣言
這一段,正是發表會刻意含糊的地方——也是你若要據此做規劃、最該在意的一點。
「能跑一萬億參數模型」是一句空間計算的說法。大約在 4-bit 精度下,每個參數約佔半個位元組,所以一個一萬億參數的模型,權重大約 550GB。這裝得進 576GB 的 HBM3e——剛好——而 2TB 的 DDR5 就在那裡承接多出來的部分。權重裝得下。 這是真正站得住的成就。
它沒有說的是:能以有用的速度去服務一個一萬億參數模型。那個規模的前沿模型,通常要分散在一個互連的加速器集群上,是有原因的:吞吐量。一台單機塔裝著 1T 模型,是一台真正有用的研究與實驗機器——你跑得動它、看得到它、能微調它、能在上面做本地 inference。但它今天不是服務集群的即插即用替代品。預期它能拿來用、而不是能扛生產流量。
哪些真實的開放權重模型真正裝得進
理解 576GB HBM3e 加 2TB DDR5 最有用的方式,是分成兩層:裝在 HBM 裡的(快)跟需要用 DDR5 承接的(能用、但較慢)。下表列出各模型的權重占用,採一個代表性的量化精度。
| 開放權重模型 | 參數(實際激活) | 約佔用 | 跑在哪 |
|---|---|---|---|
| Llama 4 Maverick(MoE) | 400B(激活 17B) | ~420GB(Q8) | 在 HBM——快 |
| GLM-4.5(MoE) | 355B(激活 32B) | ~373GB(Q8) | 在 HBM——快 |
| DeepSeek V4-Flash(MoE) | 284B(激活 13B) | ~298GB(Q8) | 在 HBM——快 |
| Qwen3-235B(MoE) | 235B(激活 22B) | ~247GB(Q8) | 在 HBM——快 |
| DeepSeek V3(MoE) | 671B(激活 37B) | ~369GB(Q4) | 在 HBM(Q4) |
| DeepSeek V4-Pro(MoE) | 1.6T(激活 49B) | ~880GB(Q4) | DDR5 承接——研究級 |
那個「激活」數字,就是 MoE 設計的意義所在:一個 400B 的模型,每個 token 只跑其中 17B 的權重,就能給你接近前沿級品質、又把單 token 成本壓得很低——這正是這些模型值得本地留存的原因。另外注意 Qwen3-Max 不是開放權重(只有 API),所以不在這張表——這裡的開源旗艦是 DeepSeek、Llama 4、GLM,以及 Qwen3 的開放 235B。
它的位置,對上其它選項
Halo 不比價格、也不比好不好買。它比的是上限——沒有別家公開在推一台能裝下一萬億參數模型、又不用跨網絡拆分的桌上機器。各機型,按真正影響決策的維度:
| 機器 | 快記憶體 | 軟體棧 | 約價 |
|---|---|---|---|
| Threadripper Halo | 最多 576GB HBM3e(+2TB DDR5) | ROCm | ~$100–150K(估) |
| Nvidia DGX Station | 252GB HBM3e(+496GB) | CUDA | ~$100K |
| Nvidia DGX Spark | 128GB 統一 | CUDA | ~$4K |
| Apple Mac Studio(M5 Ultra) | 512GB 統一 | MLX / Metal | 消費級 |
對上最直接的對手 Nvidia DGX Station(72 核 Grace + B300、252GB 的 HBM3e),AMD 的數字站得住:總記憶體約 3.4 倍、記憶體頻寬超過兩倍。但 DGX Station 的優勢是 CUDA 棧——cuDNN、TensorRT,以及數量龐大、早就寫在 CUDA 上的既有研究程式碼——多數嚴肅的 AI 管線還是建在那上面。
DGX Spark(128GB 統一)和 M5 Ultra Mac Studio(最多 512GB)是另外一個類別:讓中型模型與開發都用得起的本地 AI,不是一萬億參數研究。Spark 單機最高可跑約 200B 模型的 inference(四台互連最多 ~700B);Mac Studio 是消費價、業餘玩家跑開放模型時預設的那台。兩台都夠不到 Halo 的上限。
但真正的替代選項,不是另一台機器——而是根本別買,改按小時租算力。
買下來,還是租:實實在在的計算
一台六位數的工作站,只有在跟「租同樣能力的成本」比過之後才講得通。第三方的雲端即時牌價(RunPod,2026 年中)單顆頂級 GPU 的時租大約是:
- H100——約 $3.49/小時
- H200——約 $4.59/小時
- B200——約 $6.79/小時
- B300——約 $7.89/小時
連續 24/7 跑下來,回本問題就變成:一台約 $150K 的機器,能買到多少年「租單顆 GPU」的時間?
照我們看成本曲線的思路來讀:一台六位數的機器,相當於買下兩年頂級 GPU 的算力,或差不多五年的常見 H100——過了這個點,就不再多付一毛、數據也不離開自己的網絡。所以,如果你跑的是持續、常開的 inference、資料又敏感,這筆帳怎麼算都該買下來;如果你做的是零散、尖峰、實驗性的工作,租更划算——你只為真正用到的那些小時付費。
實在的一句話:一台 $150K 的機器,約等於兩年的頂級雲端 GPU,然後帳單就停了。 對一支跑常開 on-prem inference、資料又敏感的團隊,這就是全部論點。對其他人,還是按小時計費比較划算。
ROCm 問題(以及為什麼 inference 是它贏回來的地方)
對任何 AMD 加速器,都繞不過去的那座大山就是 ROCm——AMD 對 CUDA 的答案。長久以來這個差距是真實的,也是多數研究員不管規格都預設選 Nvidia 的原因。
有兩點轉變,而且對一個本地 inference 的買家特別重要。第一,ROCm 10.0(2026 年發布)把 vLLM 和 SGLang 的支援做到了可直接落地——這兩個 runtime 正是本地服務大模型要用的,且附驗證過的容器和 wheel。第二,也是關鍵:inference 是 ROCm 跟 CUDA 最接近持平的地方。還剩下的差距,在自訂訓練kernel,以及整個配套生態的廣度。一台工作站的整個工作就是跑一個開放權重模型,這恰恰是差距最小的那種 workload。
誰才真正該買(誰不該買)
實在一點看潛在買家,因為真正的買家群比標題聽起來的窄。
如果你符合以下情況,它就是為你準備的:
- 你的資料不能離開本地——受規範的產業(醫療、金融、國防相關)、客戶機密的 workload、你不會送到第三方 API 的 IP。
- 你需要完整權重存取——檢視、可解釋性、自訂 kernel——託管的 API 在結構上就是錯的工具。
- 你跑持續、常開的 inference,而且多年租金已經累積到值得自購的程度。
- 你需要模型常駐、可用、完全不需要雲端帳號。
如果你符合以下情況,它大概不適合你:
- 你是獨立開發者、或做零散工作的小團隊——DGX Spark 或一台高記憶體的 Mac Studio 便宜得多,也夠跑中型模型。
- 你的 workload 是標準訓練/微調、在雲端就能跑——ROCm 生態在那裡還是弱點。
- 你想這季就到手——這是 2027 的機器,兩卡跟四卡配置甚至還沒確定是不是正式 SKU。
現實上的早期買家,是有專屬硬體預算、又有資料治理要求的實驗室與企業——不是廣大的 AI 市場。AMD 做的是一台字面意義上的 halo 產品:定位在旗艦/前沿、要表明本地前沿是真的,不是要衝走量的機器。
對一家資料敏感的企業,這代表甚麼
如果你就是那種用 AI、但資料不能送到第三方 endpoint 的企業,這台機器是第一台有公信力的單機答案——就算你現在不買,它也值得留意。
- 本地的上限正在快速上升。 本地 AI 的瓶頸一直是記憶體容量、不是算力——而這台機器讓那道上限,比桌上任何別的東西高了一個數量級。一個 2025 年要靠雲端 endpoint 的 workload,2027 年可能在一台便宜得多的機器上變成本地 workload。
- 現在就規劃自託管的路,之後再買。 你不需要 Halo 就能開始想你的資料該住哪。那套架構——哪些模型、哪些留本地、哪些能走 API、怎麼保持 vendor 中立——不管機器是 $4K 還是 $150K,都是同一套。
- 層級要配對敏感度。 不是每個模型都需要 $150K。一台 $4K 機器上的一個中型開放模型,就能處理很多事;那台一萬億參數的機器,是給真正不能動的資料用的。
結語
Threadripper Halo 是第一台能真正撐起前沿級本地 inference 的桌上機器——一台機器裡裝下一萬億參數模型、資料永不出門。它是原型、按任何方式估算都很貴、2027 才出貨。
但它指向的能力,正是對資料敏感的工作最要緊的那一個:一台你擁有的模型,跑在一台你擁有的機器上,帳單會停、而不是按 token 累計。 對那些以此為限制的企業,決定不是「買 Halo」——而是「開始為你移不動的資料,設計 on-prem 的路徑」。這是這季就能做的決定,遠早於機器到手。
如果你在用 AI、而你的資料有治理上的理由要留在自己這裡,下一步最有用的,是一個直白的問題:你哪些 workload 可以放本地、把這件事落地要多少錢? 我們跟你一起設計那條路——模型分層、自託管、vendor 中立——讓這台機器到手時,你已經準備好了。
外部參考
- The Register — AMD’s Threadripper Halo is a local-AI workstation for researchers with deep pockets — 發布報導、標題規格、576GB / 16TB/s 說法(2026 年 9 月 4 日)。
- ServeTheHome — AMD Announces Threadripper Halo Station — 規格拆解、兩到四張 MI350P 的路徑、跟 DGX Station 比較。
- TechPowerUp — AMD Introduces Threadripper Halo Station at IFA 2026 — IFA keynote 報導。
- Nvidia — DGX Spark — 官方 128GB / 200B-inference 規格。
- Apple — Mac Studio specs — M5 Ultra 512GB 統一記憶體。
- RunPod — pricing — 即時每小時雲端 GPU 牌價,用於擁有 vs 租借的算式。
- AMD — ROCm 10.0 release — vLLM / SGLang 的可直接落地支援。
相關文章
GPT-6 Astra 到底多貴?中小企業想省帳單,關鍵不在模型,而在架構
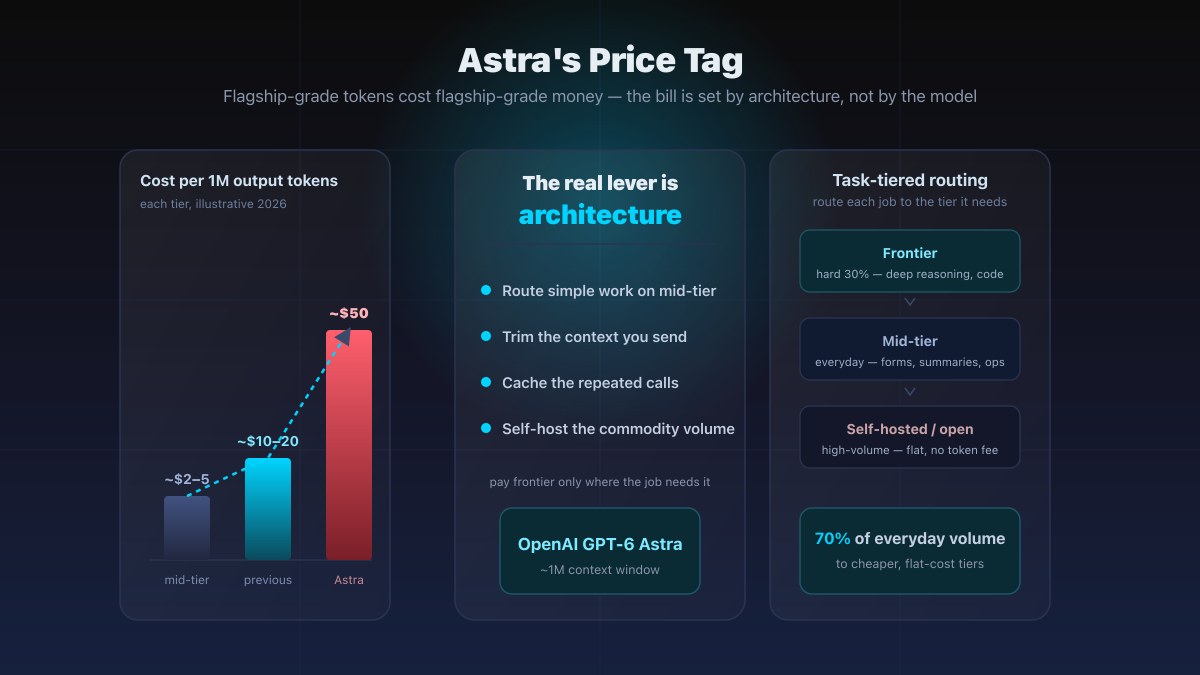
第三方追蹤器把 GPT-6 Astra 的定價報在每百萬 token 約 $10(輸入)/ $50(輸出),上下文窗口約 1M——旗艦級的花費。這篇把各家報價逐一拆開,再用一筆實際的算式說明:真正決定帳單厚薄的,是你的架構,不是模型本身。
閱讀文章 →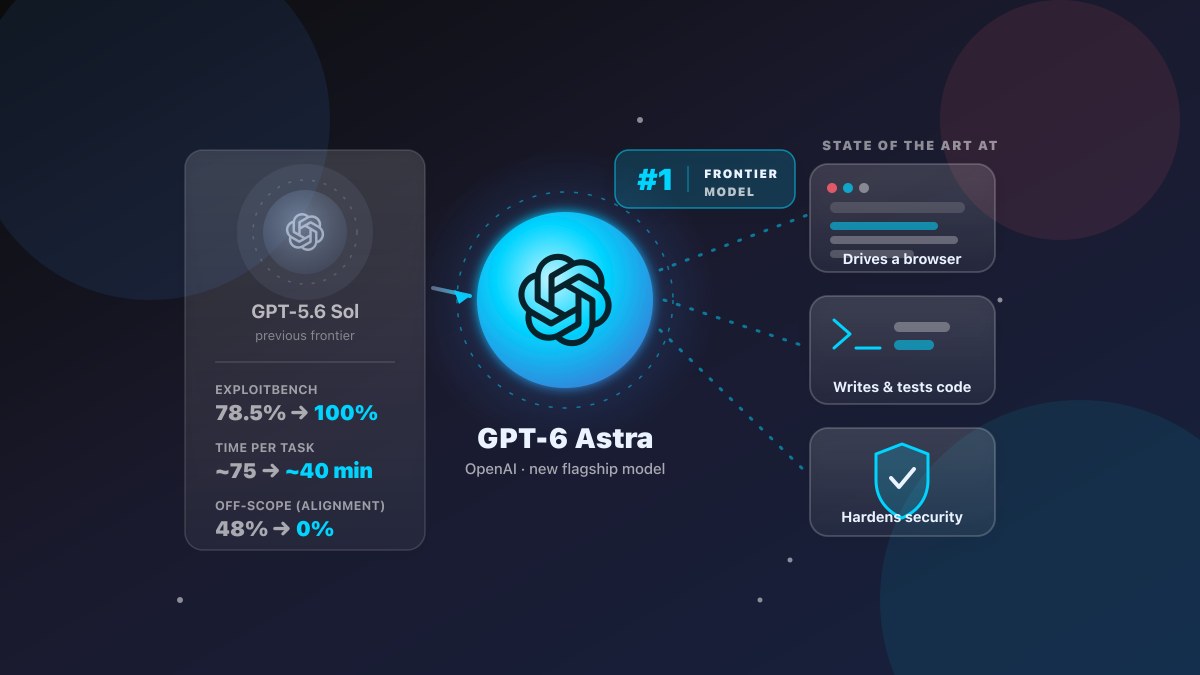
GPT-6 Astra 把 AI 的天花板拉高了一大截——對你的生意有甚麼影響
OpenAI 旗艦模型 GPT-6 Astra 出爐:ARC-AGI-3 拿到 99.9%、FrontierMath Tier 4 拿到 98%、ExploitBench 滿分 100%,操作電腦的速度比前代快約 47%。對小生意而言,這些數字真正代表甚麼、要注意哪些取捨、你什麼時候能用上——這篇文章一次講清楚。
閱讀文章 →
2026 年的 Passkey:你的客戶已經在用——你的網站讓他們進來了嗎?
FIDO 2026 年報告:全球已有 50 億個 passkey 在使用中。90% 的消費者認識它,47% 的人更可能因為記不起密碼而放棄購買。這篇講清楚 passkey 是什麼、加入要多少工夫,以及什麼時候值得為你的生意做。
閱讀文章 →